Huit projets, tous décrits selon le même plan : le contexte, le problème réel, ce que j'ai fait,
les décisions techniques que j'ai prises et ce qu'elles ont donné. Le bloc des décisions est
celui qui compte : il montre le raisonnement, pas seulement la liste des outils.
Chaque projet porte la mention de sa nature, professionnelle, technique ou académique.
Rien n'est présenté pour autre chose que ce qu'il est.
Pilotage de la performance par indicateurs, ERP Dolibarr et Metabase
BH2M, Belfort · Fév. 2026 - Juil. 2026 · Assistant Chef de Projet Digitalisation Industrielle et SI
Un ERP qui alimente directement les indicateurs, au lieu de fichiers ressaisis à la main.
SQLMySQL / MariaDBMetabaseERP DolibarrDIGIRISKRéférentiel MASE
Une seule source, l'ERP. Un tableau de bord par processus métier plutôt qu'un écran unique : chaque responsable ouvre sa vue et y trouve ses chiffres, pas ceux des autres.
Contexte
BH2M est un bureau d'études en conception et rénovation d'alternateurs hydroélectriques
jusqu'à 400 MW. PME créée en 2021 pour reprendre l'expertise de la division Hydro de
General Electric à Belfort, certifiée ISO 9001 depuis décembre 2023. J'y suis Assistant
Chef de Projet Digitalisation Industrielle et SI, en stage de fin d'études de 6 mois.
Ma mission : concevoir et déployer les tableaux de bord de pilotage connectés à l'ERP
Dolibarr, sur trois processus métiers, Offre commerciale, SSE et Achats.
Le problème
Les données de gestion vivaient dans l'ERP, mais les indicateurs de pilotage se
construisaient à côté, dans des fichiers alimentés à la main. Pas de source unique :
selon le fichier ouvert, deux personnes pouvaient donner deux réponses différentes
à la même question.
Ce que j'ai fait
Processus Offre commerciale
→
Suivi des offres fermes par trimestre et par type de projet, en montant et en volume.
→
Suivi des commandes clients par trimestre, en montant et en nombre.
→
Backlog des offres fermes en attente de décision, avec snapshots automatiques.
→
Calcul du taux horaire vendu, montant facturé rapporté aux heures vendues, avec
suivi trimestriel et moyenne glissante sur 12 mois. Industrialisation d'un calcul
de rentabilité jusque-là réalisé manuellement.
Processus SSE, référentiel MASE
→
Modélisation d'une source de données unique croisant les tâches DIGIRISK,
les tickets SSE et les déclarations.
→
Répartition des tickets par famille et par catégorie.
→
Indicateur de tickets ouverts sur 12 mois glissants, calé sur le calendrier
fiscal MASE, de juillet à juin.
→
Distinction méthodologique entre accidents déclarés, situations dangereuses
signalées et actions correctives associées, alignée sur le référentiel MASE.
Processus Achats
→
Cartes de pilotage : commandes en cours, commandes en retard, montant engagé.
→
Tableau de bord synthétique sur l'année fiscale, d'octobre à septembre.
→
Analyse fournisseurs : top 10, délais de livraison prévus, performance achats
par portefeuille.
→
Alignement des statuts de commande sur la nomenclature exacte de Dolibarr.
Décisions techniques
Une source de données unique pour le SSE, plutôt que trois requêtes séparées.
Croiser DIGIRISK, les tickets et les déclarations dans un même modèle. Sans cela,
chaque graphique raconte sa propre histoire et le pilotage devient indéfendable
en audit.
Des fenêtres glissantes calées sur les calendriers fiscaux réels, pas sur l'année civile.
Le SSE se pilote sur le calendrier MASE, de juillet à juin, les achats sur
l'année fiscale, d'octobre à septembre. Un indicateur juste posé sur le mauvais
calendrier est un indicateur inutilisable en revue de direction.
Fidélité stricte à la sémantique de l'ERP.
Nomenclature exacte des statuts Dolibarr, et séparation nette entre date de
livraison prévue et date réelle. Un indicateur qui réinterprète sa source finit
toujours par mentir, et personne n'a à maintenir une table de correspondance
parallèle quand l'ERP évolue.
Ce que ça démontre
→
Traduire un besoin métier exprimé à l'oral ou sur papier en spécification technique.
→
Fiabiliser une donnée : repérer un indicateur trompeur avant qu'il ne serve à décider.
→
Choisir la représentation selon le message à faire passer, pas selon l'habitude.
→
Intégrer un référentiel réglementaire, ici MASE, directement dans le pilotage.
Résultat
10+ indicateurs de pilotage sur 3 processus métiers
Indicateurs alimentés directement par l'ERP, sans ressaisie. Déployé en production
chez BH2M, code propriétaire.
Transposable à
La même démarche s'applique sur SAP ou Oracle Fusion, et sur des processus Production,
Maintenance ou Qualité. Le référentiel change, la méthode non.
Aucune donnée, aucun montant, aucun volume et aucun nom de client ou de fournisseur de BH2M
ne figure sur cette page. Seule la méthode de travail est décrite.
Un modèle qui ne répond jamais de mémoire : chaque réponse cite la source dont elle vient.
GenAIRAGFlaskPineconeAPI RESTAngularSpring Boot
Le modèle ne repond jamais de mémoire : il ne voit que les passages retrouvés dans la base. C'est ce qui permet de citer la source, et ce qu'un modèle affiné ne sait pas faire.
Contexte
Mission d'Ingénieur R&D IA en remote pour un client international, sur une base de
connaissances propriétaire.
Le problème
L'information utile était dispersée dans une base de connaissances interne volumineuse
et cherchée manuellement. Un modèle de langage seul ne répond pas au besoin : il ne
connaît pas les documents internes et produit des réponses plausibles mais fausses.
Ce que j'ai fait
→
Développé le chatbot de bout en bout : backend Flask, API REST, interface de dialogue.
→
Mis en place une architecture RAG, Retrieval-Augmented Generation, adossée à la base
de connaissances propriétaire.
→
Indexé le corpus dans une base vectorielle Pinecone.
→
Mené la refonte applicative associée en Angular et Spring Boot.
Décisions techniques
RAG plutôt que fine-tuning d'un modèle.
Le corpus évolue, et le RAG permet de citer la source de chaque réponse, ce qu'un
modèle affiné ne sait pas faire.
Base vectorielle managée Pinecone.
Pas d'infrastructure de recherche vectorielle à exploiter : la mission portait sur
le produit, pas sur l'hébergement.
API REST plutôt qu'une intégration directe.
Le chatbot reste découplé des applications qui le consomment, donc réutilisable
ailleurs sans réécriture.
Résultat
500+ utilisateurs finaux · 40% de code dupliqué en moins · +35% de performances
Chatbot en production. La refonte applicative associée a réduit le code dupliqué de 40%
et amélioré les performances de 35%. Base de connaissances propriétaire, code non public.
Transposable à
La même architecture s'applique à une documentation technique industrielle, un référentiel
qualité ou un corpus de procédures : partout où la réponse existe déjà mais où personne
ne la retrouve.
03Réalisation technique
Pipeline de données industriel, Airflow et dbt
Projet personnel · Code source public
Un pipeline qui s'arrête plutôt que de livrer un chiffre faux sans prévenir personne.
AirflowdbtPostgreSQLDockerPythonpytest
ELT et non ETL : les données brutes arrivent d'abord, les transformations vivent ensuite dans dbt, versionnées dans Git et rejouables sur tout l'historique.
Contexte
Projet personnel urban-mobility-analytics, conçu
comme un pipeline de données industriel complet, de l'ingestion à la restitution analytique.
Le problème
Intégrer des APIs temps réel, garantir la qualité des données livrées et servir des data
marts analytiques, de façon reproductible et rejouable, sans intervention manuelle entre
deux étapes.
Ce que j'ai fait
→
Construit un pipeline ELT conteneurisé de bout en bout.
→
Orchestré les traitements avec Airflow : dépendances, planification, reprise sur erreur.
→
Écrit les transformations en dbt vers un entrepôt PostgreSQL.
→
Intégré des APIs temps réel et modélisé des data marts analytiques.
→
Mis en place des contrôles qualité dbt, des tests unitaires pytest, du monitoring
et des alertes.
Décisions techniques
ELT plutôt qu'ETL.
Les transformations vivent dans dbt, versionnées dans Git, relisibles et rejouables
sur l'historique. Un ETL en boîte noire ne permet ni l'un ni l'autre.
Docker sur toute la chaîne.
Le pipeline se relance à l'identique sur n'importe quelle machine. C'est la
condition d'un passage en production, pas un confort de développement.
Tests dbt et pytest en amont de la restitution.
Mieux vaut un pipeline qui s'arrête qu'un tableau de bord qui affiche des chiffres
faux sans prévenir personne.
Résultat
600k+ lignes traitées par mois · Contrôles qualité automatisés
Pipeline complet, testé et conteneurisé. Le code est public et lisible.
La même chaîne alimente un entrepôt industriel depuis un ERP, un MES ou des capteurs
d'atelier. La source change, l'orchestration, les tests et la modélisation restent.
04Réalisation technique
Batica, preuve de chantier vérifiable pour un financement à distance
Projet personnel · Plateforme web et mobile déployée
Payer un chantier à 5 000 km sur la foi d'une photo WhatsApp, ou payer sur une preuve qui dit d'où elle vient, quand elle a été prise et à quel jalon elle correspond.
La plateforme s'arrête volontairement avant l'argent. Elle produit la preuve et la rend lisible ; la décision de payer, et le paiement lui-même, restent chez celui qui finance.
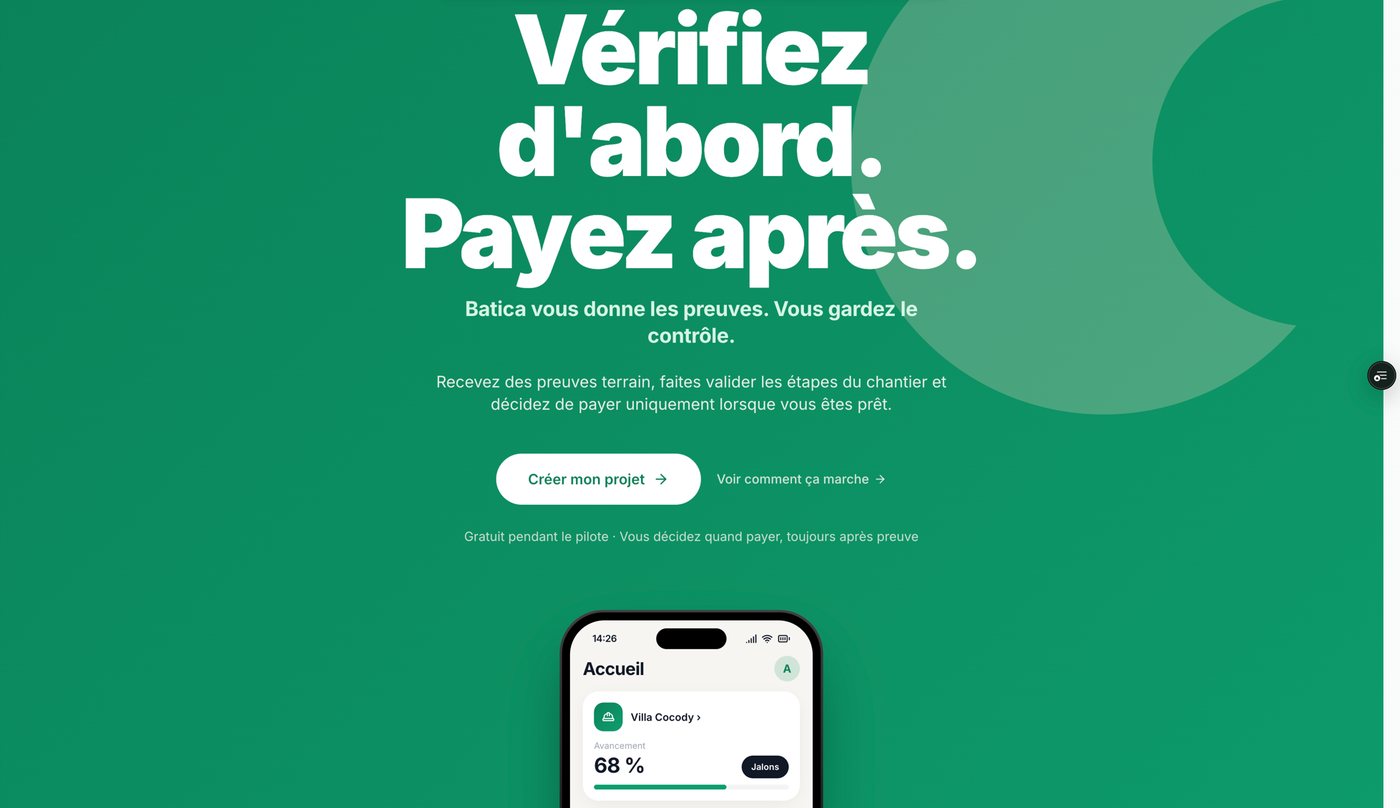
La page d'accueil publique de Batica. La promesse tient en deux phrases, et la maquette mobile montre un chantier découpé en jalons avec son avancement. Plateforme en bêta, aucun chantier réel n'y est suivi.
Contexte
Projet personnel. Une plateforme de suivi de chantier destinée à la diaspora africaine :
on vit en France, on finance la construction d'une maison au Togo, et on libère les fonds
au fil des jalons sans pouvoir se rendre sur place. Cinq rôles cohabitent, client,
fournisseur, chef de chantier, agent d'inspection et administrateur, chacun avec son
parcours web et mobile.
Le problème
Une photo envoyée par WhatsApp ne prouve rien. Elle ne dit ni où elle a été prise, ni
quand, ni à quel jalon elle correspond, ni si elle a déjà servi une première fois. Celui
qui finance décide donc à l'aveugle, à 5 000 km. Le réflexe attendu serait de sécuriser
l'argent en le faisant transiter par la plateforme. J'ai pris le problème dans l'autre
sens : produire la preuve, et laisser la décision de payer à celui qui finance.
Ce que j'ai fait
La chaîne de preuve
→
Découpage du chantier en jalons par le client, chaque jalon portant sa propre
condition de livraison.
→
QR affiché sur le chantier, scanné par le fournisseur au moment de la livraison.
→
Photo prise depuis l'application mobile, avec position GPS et horodatage.
→
Croisement de la position GPS, de l'horodatage EXIF, de l'empreinte de l'image et
de la validité du QR pour produire un score de fraude.
→
Validation de la conformité physique par le chef de chantier, tenue séparée du
contrôle automatique : une preuve authentique peut porter sur des travaux non conformes.
Les cinq parcours, web et mobile
→
Web en Next.js 16 : App Router, Server Components et Server Actions, avec un
middleware qui route chaque utilisateur selon son rôle.
→
Mobile en Expo et React Native avec expo-router : appareil photo, localisation,
stockage sécurisé et manipulation d'image.
→
Authentification Supabase Auth, partagée par les deux clients.
L'industrialisation
→
Base PostgreSQL sur Supabase : 29 tables et 108 policies Row Level Security.
→
Stockage des photos en buckets privés, lecture par URL signée uniquement.
→
Observabilité Sentry et PostHog, tests Jest et Testing Library côté mobile,
tests de bout en bout.
→
CI GitHub Actions : typage web, typage mobile, lint, tests de bout en bout,
contrôle de dérive de schéma et rejeu des migrations sur une base éphémère.
→
Déploiement continu, Vercel pour le web et EAS pour le mobile.
Décisions techniques
Ne jamais toucher à l'argent.
Le paiement reste sur Wave, Orange Money, MoMo ou un virement. C'est d'abord un
choix produit : la plateforme vend de la certitude, pas un compte de plus. C'est
aussi ce qui la tient à l'écart du statut d'établissement de paiement, et donc
d'un agrément que l'on ne porte pas seul.
Les autorisations en base, pas dans l'application.
108 policies Row Level Security portent la règle d'accès dans PostgreSQL. Avec
cinq rôles et deux clients, web et mobile, une règle écrite dans le code
applicatif aurait dû être écrite deux fois, et aurait donc fini par diverger.
Écrite en base, elle s'applique quel que soit le chemin d'entrée.
Buckets privés et URL signées.
Une preuve n'a de valeur que si elle n'est pas consultable par n'importe qui.
Aucune photo n'est servie en lecture publique ; chaque accès passe par une URL
signée, à durée de vie limitée.
Le schéma vérifié à chaque commit.
La CI contrôle la dérive de schéma et rejoue les migrations sur une base
éphémère. Quand la sécurité vit dans la base, une migration qui passe en local
et casse en production ouvre un trou d'autorisation, pas seulement un bug.
Ce que ça démontre
→
Concevoir une chaîne de traçabilité complète, de la saisie sur le terrain à la
décision de celui qui paie.
→
Modéliser des droits d'accès pour cinq rôles distincts et les tenir à un seul endroit.
→
Faire tenir ensemble une contrainte réglementaire et une décision d'architecture,
au lieu de les traiter séparément.
→
Livrer et maintenir deux clients, web et mobile, sur un même modèle de données.
Plateforme déployée, web sur Vercel et mobile sur EAS, avec les cinq parcours en place.
Aucun chantier réel n'y est suivi à ce jour : c'est un projet personnel, pas un produit
en exploitation.
La même chaîne sert une réception de matériel en usine, une validation de jalon sur un
chantier industriel ou un contrôle qualité par photo horodatée. Le terrain change, le
principe reste : une preuve rattachée à un lieu, à une date et à une étape, contrôlée
automatiquement puis validée par un humain.
05Académique
Étude de faisabilité d'un projet d'infrastructure, Mersey Gateway
UTBM, Master 2 Affaires Industrielles Internationales · Projet fil rouge, équipe de 5
Chiffrer un pont avant qu'il existe : plusieurs scénarios, un coût par scénario, et une recommandation à défendre devant un jury.
Planification de projetEstimation de coûtsAnalyse financièreAnalyse de scénariosÉtude de faisabilitéGestion de projet international
La recommandation arrive en bout de chaîne, jamais au début. C'est ce qui la rend défendable : chaque chiffre remonte à une hypothèse écrite.
Contexte
Étude de cas sur le Mersey Gateway, pont à péage franchissant la Mersey et le canal
maritime de Manchester, entre Runcorn et Widnes en Angleterre. L'ouvrage a ouvert en
octobre 2017 : 600 millions de livres de coût de construction, et 1,86 milliard sur
toute sa durée de vie, conception, financement, exploitation et maintenance compris
jusqu'en 2044. Projet fil rouge du Master 2 Affaires Industrielles Internationales,
mené en équipe de cinq.
Le problème
Un ouvrage de cette taille se décide avant d'exister. Il faut estimer ce qu'il coûtera,
sous quelles contraintes techniques et opérationnelles, et dire s'il tient debout
financièrement, à partir de données publiques nécessairement incomplètes.
Ce que j'ai fait
→
Analysé le cahier des charges et les exigences du projet, contraintes techniques et
opérationnelles comprises.
→
Réalisé l'estimation détaillée des coûts et l'analyse financière du projet, sur
plusieurs scénarios.
→
Élaboré et présenté des recommandations évaluant la faisabilité et la performance
globale du projet.
Ce que ça démontre
→
Chiffrer un investissement avant de le lancer, plutôt que constater le dépassement
après.
→
Raisonner en scénarios plutôt qu'en chiffre unique, et rendre chaque écart explicable
par l'hypothèse qui le produit.
→
Défendre une recommandation devant des interlocuteurs qui la contestent.
→
Travailler à cinq sur un livrable unique, en contexte international.
Résultat
Recommandations de faisabilité élaborées et soutenues devant un jury d'experts.
Transposable à
Le chiffrage d'un investissement industriel, l'arbitrage entre scénarios de
renouvellement d'équipement ou d'implantation d'une ligne. L'ouvrage change, la méthode
ne change pas : hypothèses écrites, coûts par scénario, recommandation défendable.
06Académique
Back-end métier en microservice Java, gestion immobilière
Projet de soutenance · Code source public
Un dossier par domaine métier, pour que chacun évolue sans obliger à relire les autres.
JavaSpring BootMavenAPI RESTArchitecture en couchesIntégration de service tiers
Un dossier par domaine métier, pas un dossier par type technique : chaque domaine évolue sans obliger à relire les trois autres.
Contexte
Projet de soutenance : une application de gestion de biens immobiliers construite
comme un microservice Java. Elle couvre quatre domaines métier : les utilisateurs, les
publications, les opérations d'achat et de location, et la vérification de personnes
avec envoi de SMS.
Le problème
Quatre domaines métier dans une même application, c'est le scénario classique du back-end
qui devient un bloc unique où plus personne n'ose toucher quoi que ce soit. La difficulté
n'est pas d'écrire les fonctionnalités, c'est de les séparer assez nettement pour qu'elles
évoluent sans se gêner.
Ce que j'ai fait
→
Modélisé le domaine avant d'écrire le code, diagramme de classes à l'appui.
→
Découpé les contrôleurs par domaine métier : utilisateurs, immobilier, achat et
location, publication.
→
Séparé les interfaces de service de leurs implémentations, et isolé l'accès aux
données dans une couche DAO dédiée.
→
Intégré un fournisseur SMS tiers pour la vérification de personnes.
→
Fourni le wrapper Maven et les tests, pour que le projet se compile et se vérifie
sur n'importe quel poste.
Décisions techniques
Découpage par domaine métier plutôt que par type technique.
Un dossier par domaine, pas un dossier « tous les contrôleurs ». Chaque domaine
évolue sans obliger à relire les trois autres. C'est le même réflexe que sur les
tableaux de bord BH2M : un espace par processus plutôt qu'un écran fourre-tout.
Interfaces de service séparées des implémentations.
On remplace une implémentation sans toucher aux appelants, et on teste avec des
doublures plutôt qu'avec la vraie base de données.
Secrets du fournisseur SMS dans la configuration, jamais dans le code.
Une clé d'API commitée dans Git y reste, même après suppression du fichier.
La configuration est le seul endroit acceptable.
Wrapper Maven versionné avec le projet.
Tout le monde compile avec la même version de Maven, y compris une machine qui ne
l'a pas installé. Même raisonnement que Docker sur le pipeline de données.
Ce que ça démontre
→
Concevoir avant de coder : modèle de domaine, puis structure, puis implémentation.
→
Découper une application en domaines métier, la compétence qui sert ensuite à
cartographier un système d'information.
→
Séparer les couches pour rendre le code testable et remplaçable.
→
Intégrer un service tiers et gérer ses secrets proprement.
Résultat
Application complète et structurée, du modèle de domaine aux tests. Le code est public
et lisible.
La même structure porte un back-office industriel : gestion d'équipements, de demandes
d'intervention, de non-conformités. Le domaine change, le découpage tient. Et intégrer un
fournisseur SMS, c'est mécaniquement la même chose qu'intégrer un ERP ou un MES par API.
Casser une chaîne logistique en simulation, pour ne pas avoir à la casser en vrai.
PythonSimPySimulation à événements discretsJumeau numérique
On ne peut pas provoquer une vraie rupture d'approvisionnement pour en mesurer le coût. La simulation est le seul endroit où l'on peut casser des choses sans conséquence.
Contexte
Projet du Master 2 Affaires Industrielles Internationales à l'UTBM, sur la résilience
des chaînes logistiques.
Le problème
Une entreprise ne peut pas provoquer une rupture d'approvisionnement pour mesurer ce
qu'elle coûte. Il faut donc un modèle sur lequel on peut casser des choses sans
conséquence.
Ce que j'ai fait
→
Modélisé une chaîne logistique en simulation à événements discrets, avec Python et SimPy.
→
Simulé des ruptures et analysé leur propagation le long de la chaîne.
→
Calculé les indicateurs TTR, Time To Recover, et TTS, Time To Survive.
→
Traduit les résultats en implications concrètes pour la planification industrielle.
Décisions techniques
Simulation à événements discrets plutôt qu'un modèle analytique.
Seule la simulation montre la propagation d'une rupture dans le temps. Un modèle
fermé donne un résultat moyen qui masque justement l'effet que l'on cherche à mesurer.
Indicateurs TTR et TTS.
Ce sont les métriques de référence de la littérature sur la résilience : les
résultats sont comparables et défendables face à quelqu'un du métier.
Résultat
Un jumeau numérique permettant de comparer des scénarios de rupture avant de figer un
plan industriel.
Arbitrer entre coût, délai et exposition au risque sur une chaîne multi-pays.
Supply chainAnalyse de coûtsGestion des risquesPlanification industrielle
Contexte
Projet du Master 2 Affaires Industrielles Internationales à l'UTBM, sur une chaîne
d'approvisionnement en contexte international.
Le problème
Arbitrer entre coût, délai et exposition au risque sur une chaîne d'approvisionnement
multi-pays, où le trajet le moins cher n'est jamais le plus sûr.
Ce que j'ai fait
→
Analysé la structure de coûts de la chaîne.
→
Identifié et hiérarchisé les risques.
→
Construit la planification industrielle associée.
Autres réalisations
Le reste du code
Projets plus courts, décrits en quelques lignes plutôt qu'au format complet.
Le code est public, c'est lui qui parle.
JavaSpring BootSpring SecurityJWTMongoDBOpenAPI
OffreAPI, API REST sécurisée de gestion d'offres
API REST dont les endpoints sont protégés par Spring Security et des jetons JWT,
avec persistance MongoDB, validation des entrées, notifications par email et
tests unitaires.
Deux choix qui comptent : l'authentification est traitée comme une couche à part,
pas comme un contrôle dispersé dans les contrôleurs ; et la documentation OpenAPI
est générée depuis le code, donc une autre équipe peut consommer l'API sans
réunion et sans qu'elle se périme.
Je détaille volontiers la démarche, les requêtes ou les arbitrages. Je suis disponible en CDI,
sur des postes d'ingénieur digitalisation industrielle, méthodes et amélioration continue,
ou data et pilotage industriel.